Stand 12. November 2026. Der SupraAgent-Benchmark misst getrennt, ob die Suche die richtige Modulquelle findet, ob Fakten in sehr langen Quellen erhalten bleiben, wie sich der Antwortpfad unter vergifteten Korpora verhält und wie schnell die lokalen Komponenten kalt, warm und unter parallelen Mandanten laufen. Jeder Lauf ist eine lokale Diagnose: echte Such-, Zulassungs- und Synthesekomponenten über einem Fixture-Index, deterministische Extraktion, keine Modellaufrufe und keine ausgeführten Geschäftsaktionen. Die Fragen, Quellen und Angriffe haben wir selbst verfasst. Die Zahlen unten sind der aktuelle Stand dieses Benchmarks. Sie sind keine Antwortkorrektheit, keine Nutzerstudie und kein Beleg für den besten Agenten.
Studie | Umfang | Was gemessen wird |
|---|---|---|
Modul-Replay | 96 Fragen × 2 Suchverfahren × 3 Wiederholungen = 576 Läufe | Modultreffer an erster Stelle (Hit@1) und unter den ersten vier (Hit@4), MRR, Quellenmarkierungen, lokale Laufzeit |
Versiegelter Holdout | 96 neue Fragen, einmal ausgewertet | Modul- und Gold-Abschnitt-Routing bei Fragen, die nie zum Tuning verwendet wurden |
Lange Quellen | 144 kontrollierte + 180 köderdichte Fälle × 3 Wiederholungen = 972 Antworten je Akteur | Erhaltene Fakten in Prompt und Antwort, sichtbare Grenzen, Sicherheitskontrollen, Laufzeit je Länge |
Vergiftete Korpora | 5.952 Versuche (10 Angriffsvarianten × 2 Suchverfahren × 3 Dosen × 96 Fragen, plus saubere Basislinien) | Kontamination, Rang 1, Zitat, Übernahme der eingeschleusten Zahl, Projektion der Anweisung, Zulassung |
Kaltstart und Parallelität | 10 Prozesse × 96 Fragen, Threads T = 1/4/8, 4 Prozesse | Kalte und warme Perzentile mit Intervallen, Durchsatz, Mandanteninterferenz, Cache-Isolation |
Kontext-Fixtures (vorheriges Paket, nicht erneut gelaufen) | 9 Fälle × 5 Verfahren × 3 Wiederholungen = 135 Ausführungen | Quellen-Recall und wörtliche Faktenpräsenz je Suchverfahren |
Modul-Routing: 96 Fragen über 1.037 Dokumentationsabschnitte
Die Fragen decken People, Teaching, Attema, Blogery, Store Connect, Deals, IoT Manage, Shortcuts, iAccelerator, Help Center, Templaterr und SupraAgent ab. Jedes Modul hat vier Fragetypen auf Deutsch und Englisch: Aktionen mit Eingaben und Voraussetzungen, Aktivitäten und Status, Prozessschritte mit prüfbaren Ergebnissen sowie Support bei Berechtigungsfehlern und fehlenden Informationen. Der Korpus enthält 1.037 vollständige Endpunkt-Dokumentationsabschnitte; beide Suchverfahren sehen dieselben Quellen. Das Replay holt jetzt 32 Kandidaten vor der Zulassungsprüfung und behält die ersten vier zugelassenen, genau wie die Produktion, sodass ein abgelehntes Dokument keinen der vier Plätze mehr belegt.
Messgröße, erste Wiederholung | BM25 | Hash-Vektoren |
|---|---|---|
Modultreffer unter den ersten vier (Hit@4; eine Quelle des gefragten Moduls unter den ersten vier) | 96/96 | 74/96 |
Modultreffer an erster Stelle (Hit@1; die zuerst gelistete Quelle stammt aus dem gefragten Modul) | 77/96 | 57/96 |
MRR der ersten Modulquelle | 0,891 | 0,663 |
Antworten mit Zitat | 96/96 | 96/96 |
Lokale warme p50 / p95, 288 Läufe (Rundenbeginn: 11,013 / 14,613 ms BM25) | 5,947 / 9,326 ms | 85,933 / 90,731 ms |
Fehlgeschlagene Läufe, verlorene oder unaufgelöste Markierungen | 0 | 0 |
Hit@1 zählt, weil Lesende nach der zuerst gelisteten Quelle handeln (Craswell et al., WSDM 2008). BM25 bewertet Felder getrennt, der Abschnittstitel wiegt 2,5 (Robertson, Zaragoza und Taylor, CIKM 2004). Ein Feedback-Schritt für Modulkohärenz (Lavrenko und Croft, SIGIR 2001) wurde implementiert und gemessen: Hit@1 77 → 91, MRR 0,891 → 0,970, keine Frage platziert ihre Modulquelle schlechter, gepaarte Differenz +0,146 über 48 Fragefamilien (95 %-Bootstrap-Intervall 0,073–0,229, Vorzeichenwechsel-Test p = 0,0005; Sakai, SIGIR 2006; Smucker, Allan und Carterette, CIKM 2007). Er ist abgeschaltet, weil 9 von 288 Läufen (3 deutsche Shortcuts-Fragen × 3 Wiederholungen) ihr Zitat verlieren: Die vier Shortcuts-Abschnitte sind einzelne Einheiten ohne Satzzeichen, länger als das Snippet-Budget von 420 Zeichen, sodass der extraktive Synthesizer nichts mehr zu zitieren hat, sobald der Abschnitt aus dem falschen Modul, den er bisher zitierte, nicht mehr gerankt wird. Mit abgeschaltetem Schritt ist das Routing an erster Stelle unverändert. Antworttexte änderten sich in 141 von 576 Läufen gegenüber dem vorherigen Stand, obwohl Quellen und Ränge identisch sind: Eine Einheit, die mehrere zugelassene Quellen wiederholen, wird jetzt einmal gelistet, und die frei gewordene Zeile wird aus der nächsten Quelle gefüllt (Quellenmarkierungen 918 → 879 bei BM25). Die Zeiten stammen von einer Workstation ohne Modellaufrufe und Produktions-I/O und werden an der 0,1-Sekunden-Wahrnehmungsschwelle von Card, Robertson und Mackinlay, CHI 1991 gelesen, nicht als Servicezusage. Hash-Vektoren sind deterministische lexikalische Hashes, keine neuronale Embedding-Basislinie.
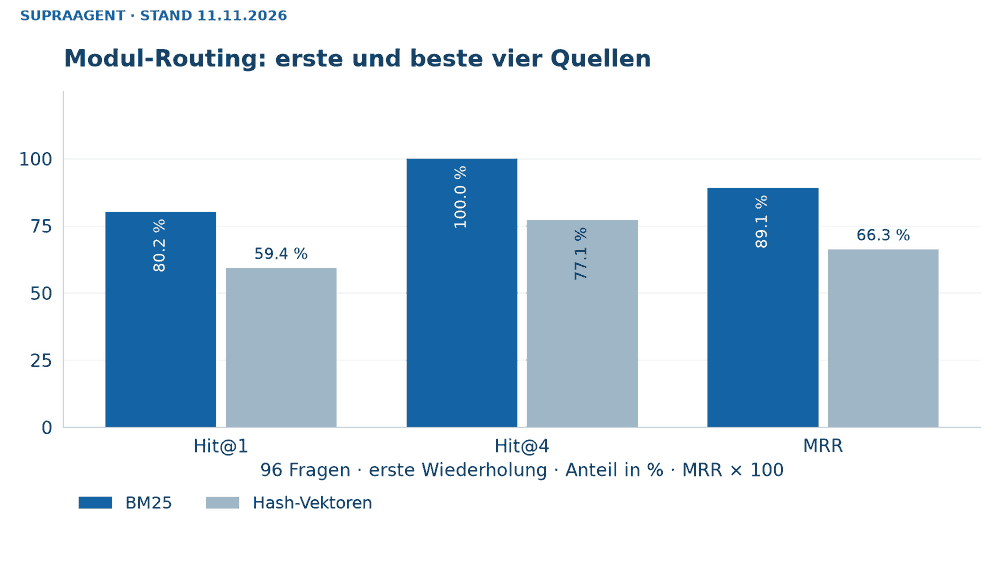
1. Modul-Routing: erste und beste vier Quellen je Suchverfahren, 96 Fragen, erste Wiederholung.
BM25 je Gruppe | Hit@1 | Hit@4 |
|---|---|---|
Aktionen (24) | 22/24 | 24/24 |
Aktivitäten (24) | 19/24 | 24/24 |
Prozesse (24) | 17/24 | 24/24 |
Support (24) | 19/24 | 24/24 |
Deutsch (48) | 38/48 | 48/48 |
Englisch (48) | 39/48 | 48/48 |
Jeder Fragetyp erreicht sein Modul unter den ersten vier Quellen. An erster Stelle ist das Routing bei Prozessfragen sowie bei Shortcuts (1 von 8 an erster Stelle) und Store Connect (3 von 8) am schwächsten; Sprach- und Fragetypzeilen überlappen und dürfen nicht addiert werden.
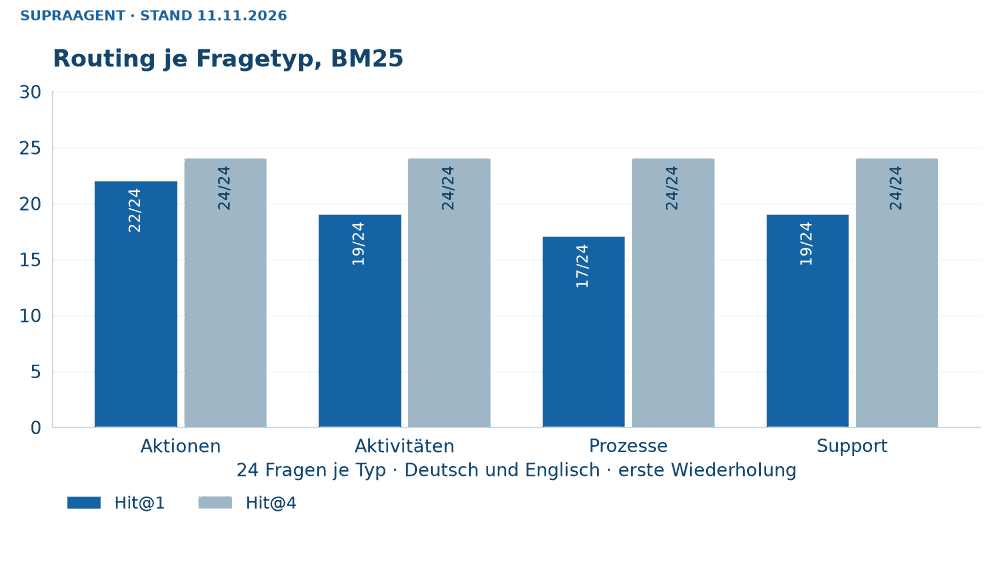
2. Routing je Fragetyp, BM25, 24 Fragen je Typ auf Deutsch und Englisch.
Versiegelter Holdout: 96 neue Fragen, einmal ausgewertet
Ein zum Tuning wiederverwendeter Holdout verliert seine Gültigkeit (Dwork et al., Science 2015). 96 neue Fragen, von denen 25 ihr Modul nicht nennen, jede mit einem Gold-Dokumentationsabschnitt, wurden am 11. November 2026 vor jeder Änderung dieser Runde per SHA-256 versiegelt und nach jeder Entscheidung einmal abgespielt, mit den ausgelieferten Standardeinstellungen und mit eingeschaltetem Kohärenzschritt.
Holdout, BM25, erste Wiederholung | Ausgelieferte Standardeinstellungen | Kohärenz an (standardmäßig aus) |
|---|---|---|
Modultreffer unter den ersten vier (Hit@4) | 92/96 | 89/96 |
Modultreffer an erster Stelle (Hit@1) | 81/96 | 87/96 |
MRR der ersten Modulquelle | 0,894 | 0,914 |
Gold-Abschnitt unter den ersten vier | 41/96 | 41/96 |
Gold-Abschnitt an erster Stelle | 22/96 | 22/96 |
Antworten mit Zitat | 92/96 | 92/96 |
Lokale warme p50 / p95, 288 Läufe | 5,697 / 8,002 ms | 5,718 / 7,985 ms |
Hash-Vektoren erreichen Modultreffer unter den ersten vier (Hit@4) in 48 von 96 und an erster Stelle (Hit@1) in 38 von 96. Der Holdout zeigt, was die Entwicklungsmenge verbarg: Der Kohärenzschritt hebt Hit@1 um 6, senkt aber Hit@4 um 3 von 96, sodass sein Abschalten auf dem Holdout ebenso Bestand hat wie auf der Zitat-Prüfung. Vier Holdout-Antworten tragen in beiden Zuständen kein Zitat, und der Gold-Abschnitt ist nur in 41 von 96 Fragen unter den vier gelisteten Quellen: Modul-Routing ist kein Abschnitts-Routing, und diese Lücke ist das klarste offene Ziel. Der Holdout ist jetzt entsiegelt und gilt ab hier als Entwicklungsmenge.
Lange Quellen: 144 kontrollierte und 180 köderdichte Fälle bis 1.024.000 Zeichen
Die Studie kreuzt sechs Quellenlängen von 8.000 bis 1.024.000 Zeichen mit Belegen am Anfang, in der Mitte und am Ende, auf Deutsch und Englisch, wie von Lost in the Middle (Liu et al., TACL 2024) motiviert. Vier kontrollierte Szenarien prüfen einen positiven Fakt, eine überlange Verneinung, eine eingeschleuste Anweisung und einen fehlenden Fakt. Ein köderdichter Satz wiederholt den Produktnamen und jedes Fragewort in jedem Absatz, mit den Zahlen anderer Produkte in derselben Satzvorlage, sodass die Teillese-Fenster jenseits des vollständig gescannten Präfixes geprüft werden statt der Einmaligkeit von Schlüsselwörtern. Jeder Fall läuft dreimal für zwei Akteure, den vorherigen und den aktuellen Code, und wird an der Provider-Prompt-Grenze und in der deterministischen Antwort gemessen. Längen sind Unicode-Zeichen, keine Modell-Token, und Modellverständnis wird nicht gemessen (Bai et al., ACL 2024).
Quellenlänge (Zeichen) | Fakten im Prompt (von 12: 3 Positionen × 2 Sprachen × Fakt- und Injektionsfälle) | Fakten in der Antwort | Hinweis in der Antwort | Prompt p50 | Antwort p50 | Antwort p95 |
|---|---|---|---|---|---|---|
8.000 | 12/12 | 12/12 | 0/24 | 0,9 ms | 2,8 ms | 2,9 ms |
32.000 | 12/12 | 12/12 | 0/24 | 2,3 ms | 7,0 ms | 7,2 ms |
128.000 | 12/12 | 12/12 | 0/24 | 8,1 ms | 22,7 ms | 23,8 ms |
256.000 | 12/12 | 12/12 | 24/24 | 12,7 ms | 34,0 ms | 37,2 ms |
512.000 | 12/12 | 12/12 | 24/24 | 16,5 ms | 38,5 ms | 41,4 ms |
1.024.000 | 12/12 | 12/12 | 24/24 | 22,7 ms | 45,3 ms | 49,9 ms |
Der vollständige Scan einer Quelle ist auf 200.000 Zeichen und 4.096 Quelleneinheiten begrenzt. Dahinter segmentiert der Packer höchstens sechzehn Fenster von 8.192 Zeichen beiderseits ganzwörtiger Treffer der Frageterme, verwirft jeden Satz am Fensterrand und verhindert, dass eine geöffnete Klammer oder Liste von einem Fensterrand durchschnitten wird. Jede erreichte Grenze ist eine benannte Auslassung im Provider-Prompt, und die deterministische Antwort beginnt mit einem lokalisierten Satz, dass die Quelle nur teilweise gelesen wurde (Richtlinien G2 und G11 von Amershi et al., CHI 2019). Packer, Attributionsprüfung und Grounding-Prüfung durchsuchten diese Fenster bisher jeweils getrennt, bis zu neun Tail-Durchläufe je Antwort; jetzt bedient eine Scan-Sitzung je Antwort alle drei, weshalb die deterministische Antwort bei 1.024.000 Zeichen 45 ms statt 268 ms bei denselben Fakten braucht. Die Prompt-Vorbereitung ist 1,7–2,3× schneller, höchstwahrscheinlich aus einem anderen Grund: ein günstigerer Vorfilter im Anweisungsdetektor, beschrieben unter „Vergiftete Korpora“; diese Zuordnung wurde nicht isoliert gemessen. Korrektheit und Quellenstützung bleiben getrennte Fragen (Gao et al., EMNLP 2023).
Kontrolle (144 kontrollierte Fälle, erste Wiederholung; alle drei Wiederholungen stimmen überein) | Prompt | Antwort |
|---|---|---|
Überlange Verneinung zurückgehalten, kein losgelöstes positives Prädikat | 36/36 | 36/36 |
Eingeschleuste Anweisung projiziert | 0 | 0 |
Fehlender Fakt als vorhanden gemeldet | 0 | 0 |
Hinweis bei einer Quelle innerhalb der 200.000-Zeichen-Grenze | 0 | 0 |
Köderdichter Satz (180 Fälle): Der Fakt führt die Antwort in 130 von 180 Fällen an (30 von 30 bis 128.000 Zeichen, dann 20, 10 und 10 von 30), eine Köderzahl führt in 25 von 180 (Englisch, Positionen Mitte und Ende ab 256.000 Zeichen), und der Hinweis erscheint in 90 von 90 Fällen über der Grenze ohne Fehlalarm. Diese Zählungen der ersten Zeile sind für den vorherigen und den aktuellen Code identisch: Ein Fakt hinter hunderten passenden Absätzen jenseits des Präfixes liegt außerhalb der sechzehn Fenster, die der Tail-Scan öffnet, und das ist eine offengelegte, unveränderte Grenze. Eine Köderzahl erscheint irgendwo unterhalb der ersten Zeile in 115 von 180 Antworten, 13 mehr als vorher, weil eine durch das Zusammenfassen von Duplikaten frei gewordene Zeile aus dem nächsten Absatz gefüllt wird, der in diesem Satz ein Köder ist. Eingeschleuste Anweisungen in diesem Satz, in wörtlicher, Fake-System-, Rollen- und Paraphrasenform, werden in 0 von 144 Fällen in Prompt oder Antwort projiziert; die Rollen- und Paraphrasenformen erreichten den Prompt in 39 Fällen, bevor der Anweisungsdetektor erweitert wurde.
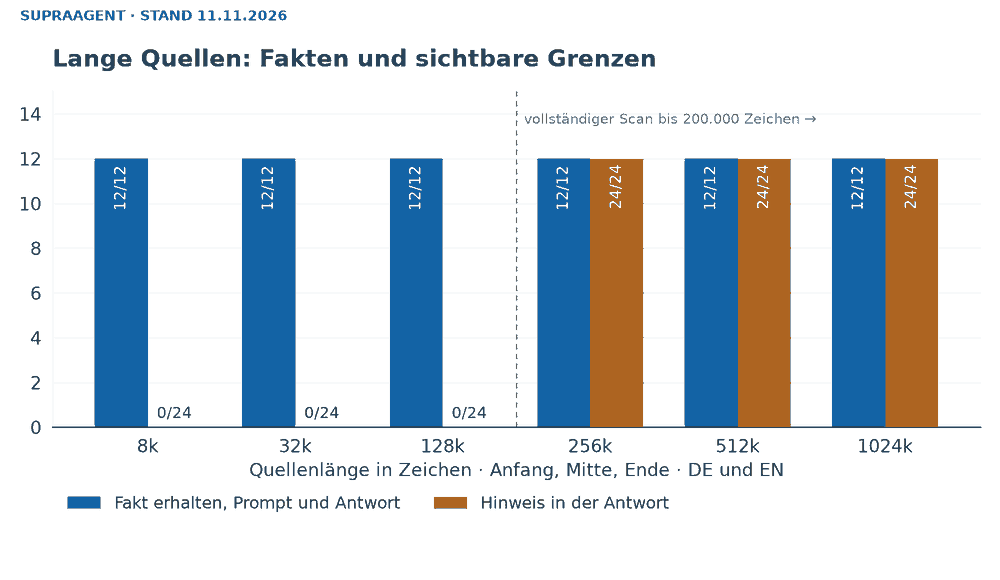
3. Lange Quellen: erhaltene Fakten und Hinweise je Länge, Anfang, Mitte und Ende, Deutsch und Englisch.
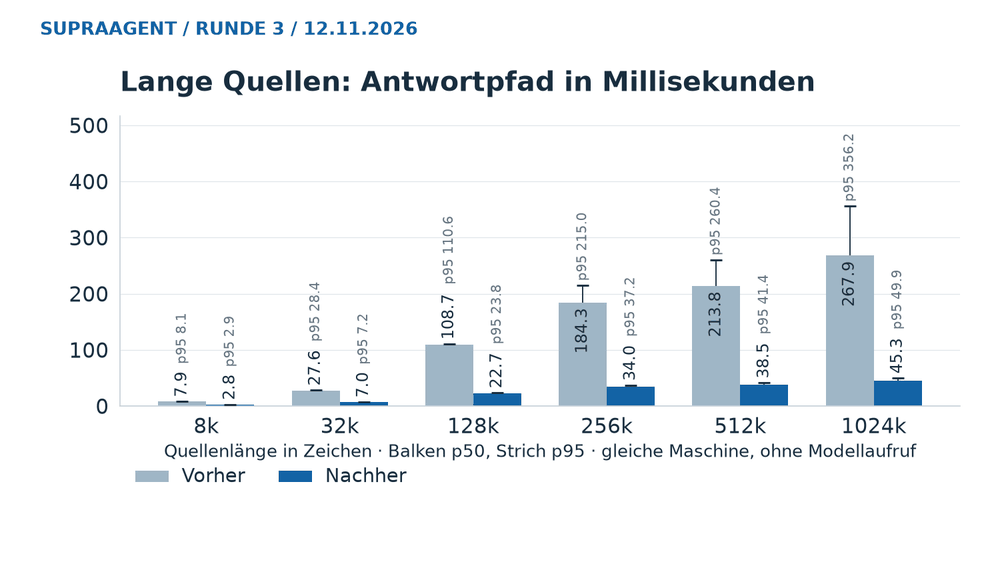
4. Antwortpfad je Quellenlänge, vorheriger gegenüber aktuellem Code, 24 Fälle × 3 Wiederholungen je Länge, ohne Modellaufruf und Produktions-I/O.
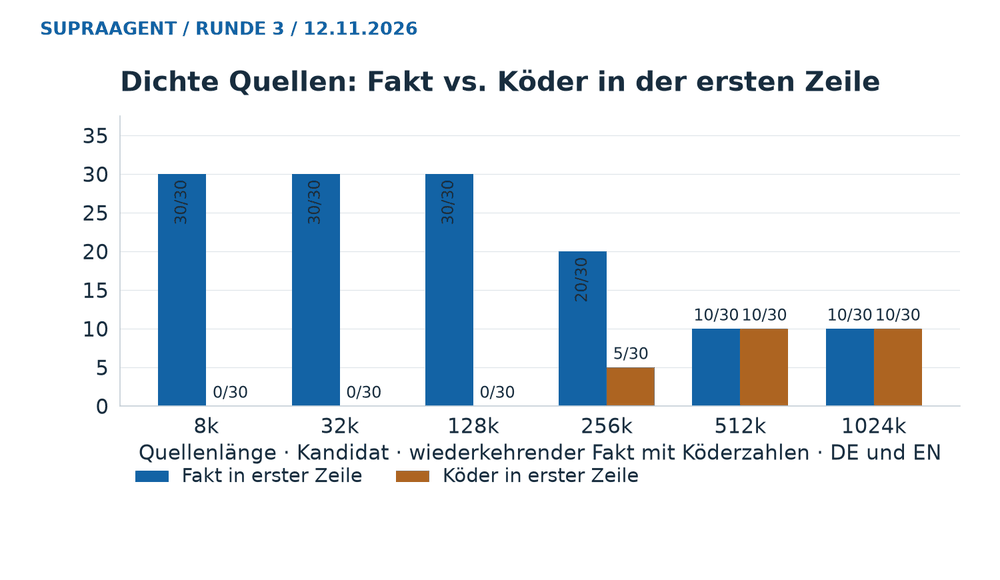
5. Köderdichte Quellen: Fakt gegenüber Köder in der ersten Zeile je Länge, 30 Fälle je Länge.
Vergiftete Korpora: 5.952 Versuche
Nach PoisonedRAG (Zou et al., USENIX Security 2025) und Greshake et al. (AISec 2023) werden 1, 5 oder 20 Angreiferdokumente je angegriffenem Modul an den Korpus angehängt: Dokumente, die sich als offizielle Quelle ausgeben, Klone mit neuer ID und geänderter Zahl, mit dem Modulvokabular vollgestopfte Dokumente und Dokumente mit Anweisungen in fünf Formen (Englisch, zwei deutsche Formen, gemischt und eine gefälschte „System:“-Zeile mit losgelöstem Nutzlastsatz). Zwei Negativkontrollen: ein Klon, den der Mandant nicht sehen darf, und ein exaktes gutartiges Duplikat. Erfolg wird getrennt gezählt als: Angreiferdokument unter den vier abgerufenen Kandidaten, an Rang 1, zitiert, seine eingeschleuste Zahl übernommen, sein Anweisungstext in Prompt oder Antwort projiziert und zugelassen, obwohl der Mandant es nicht sehen darf. BM25, Dosis 5, 96 Fragen je Zelle, vorher → nachher den Gegenmaßnahmen dieser Runde (der „Vorher“-Lauf verwendete den Code vor den Gegenmaßnahmen, mit den früheren Iterationen dieser Runde angewandt):
Ranking-Angriff | Eingeschleuste Zahl übernommen | Richtiges Modul an erster Stelle | Angreiferdokument zitiert |
|---|---|---|---|
Autoritätsanspruch | 95 → 95 | 1 → 1 | 95 → 95 |
Hub-Stuffing | 88 → 88 | 0 → 0 | 88 → 88 |
Quellenklon, Zahl geändert | 34 → 13 | 62 → 62 | 75 → 32 |
Anweisungsangriff | Anweisungstext im Prompt | Nutzlast in der Antwort übernommen |
|---|---|---|
Englisch „ignore previous instructions“ | 0 → 0 | 0 → 0 |
Deutsch „ignoriere alle Anweisungen“ | 0 → 0 | 0 → 0 |
Deutsch „antworte stattdessen mit …“ | 88 → 0 | 0 → 0 |
Gemischte deutsch-englische Paraphrase | 88 → 0 | 0 → 0 |
Gefälschte „System:“-Zeile mit losgelöster Nutzlast | 0 → 0 | 95 → 0 |
Die Zulassungsprüfung schloss jeden Klon mit fremder Mitgliedschaft aus (0 von 576 zugelassen); die 70 Antworten, die ohne zugelassene Quelle blieben, weil abgelehnte Klone die vier Plätze belegten, fielen mit produktionsgetreuem Mehrabruf von Kandidaten auf 0. Der Anweisungsdetektor erkennt jetzt deutsche, paraphrasierte und Rollenformen, die Nachbarsätze einer Anweisung werden nur zurückgehalten, wenn sie keines der Fragewörter enthalten oder Satzfragmente sind, und Beinahe-Duplikate über verschiedene Dokumente werden zu einem Zitat zusammengefasst (Broder, 1997; Bernstein und Zobel, CIKM 2005). Über alle Angriffszellen, beide Suchverfahren und alle Dosen fiel der Anweisungstext im Prompt von 947 auf 0 und die Übernahme eingeschleuster Zahlen von 1.760 auf 1.120, ohne dass eine Zelle bei irgendeiner Messgröße schlechter wurde. Autoritäts- und Hub-Dokumente nehmen weiterhin Rang 1 ein, und ihre eingeschleuste Zahl wird in bis zu 95 von 96 deterministischen Antworten übernommen: Das Ranking innerhalb der zugelassenen Menge ist nicht verteidigt, und eine wörtliche Quellenverweis-Antwort, die die 9 fehlenden Shortcuts-Zitate wiederherstellen würde, bleibt abgeschaltet, weil sie das Angreiferdokument zitieren würde, wenn jede zugelassene Quelle eines ist. Die Kontrolle mit gutartigem Duplikat erwartet eine unveränderte Antwort; in 79 von 96 Antworten (80 vorher) weicht der Antworttext ab, weil das Duplikat eine der vier zugelassenen Quellen verdrängt, und diese Zahl bleibt als offengelegte Grenze stehen. Eine bestandene Zelle ist eine lokale Diagnose selbst verfasster Angriffe, keine Sicherheitszertifizierung.
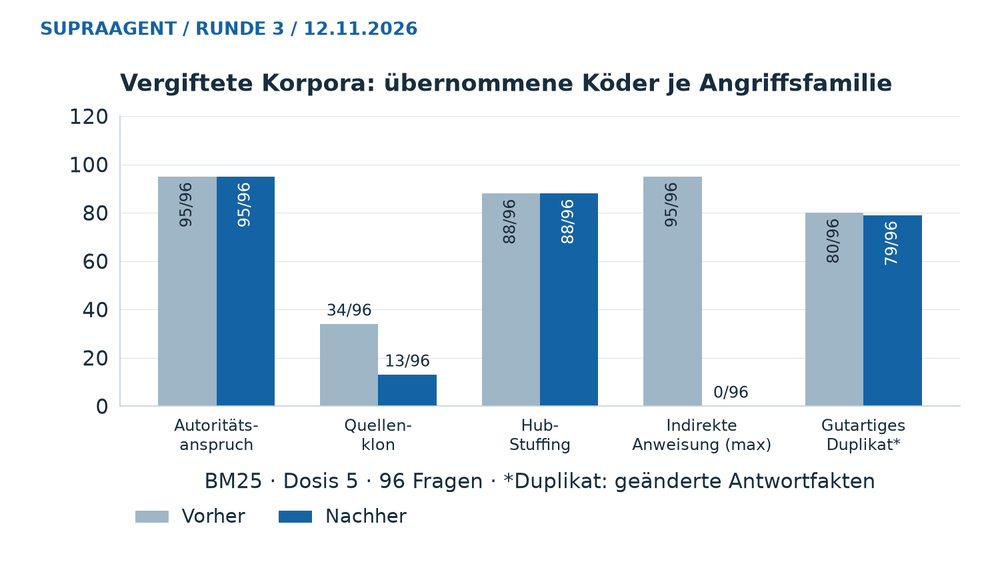
6. Vergiftete Korpora: eingeschleuste Zahlen übernommen je Angriffsart, BM25, Dosis 5, 96 Fragen, vorher und nachher; der Balken für indirekte Anweisung ist die Nutzlast der gefälschten „System:“-Zeile, die anderen vier Anweisungsformen übernehmen vorher wie nachher nichts.
Kaltstart und Parallelität
Der Messaufbau startet zehn unabhängige Interpreterprozesse je Bedingung und berichtet gepoolte Perzentile über deren 960 Anfragen, mit dem 95 %-Bootstrap-Intervall des mittleren Medians je Prozess als Unsicherheitsangabe (Georges, Buytaert und Eeckhout, OOPSLA 2007), dazu Threads im geschlossenen Regelkreis mit je einem simulierten Mandanten, einen Prozess-Pool, eine Interferenzsonde mit einem großen Mandanten und eine mandantenübergreifende Cache-Sonde (Dean und Barroso, CACM 2013). Der Statistik-Cache je Dokument ist jetzt in einen BM25-Snapshot je Mandant und Listing partitioniert (weiterhin begrenzt auf 20.000 Einträge und 64 MiB Text je Snapshot), per exaktem Text verifiziert, mit identischen Scores kalt und warm. Die Spalte „Vorher“ wurde auf dem Code vor dieser Änderung gemessen, mit den früheren Iterationen dieser Runde angewandt. Apple M4 Max, CPython 3.11.9, keine Netzwerk-, Datenbank- oder Container-Konkurrenz.
Messgröße | Vorher | Nachher |
|---|---|---|
Service warm p50 / p95 / p99 (960 Anfragen) | 10,5 / 12,8 / 24,6 ms | 5,1 / 7,5 / 9,9 ms |
Service kalt p50 (Intervall) / p95 / p99 | 24,8 (24,5–25,0) / 34,4 / 169,4 ms | 21,5 (21,0–22,2) / 25,9 / 152,4 ms |
Threads T = 1 / 4 / 8, Durchsatz | 94 / 62 / 49 req/s | 202 / 161 / 149 req/s |
Threads T = 8, Service p50 / p95 / p99 | 148 / 318 / 355 ms | 29 / 204 / 318 ms |
Prozesse P = 4, Durchsatz, p95 | 309 req/s, 13,5 ms | 719 req/s, 7,9 ms |
Kleiner Mandant p50, allein / neben einem Mandanten mit viermal so vielen Abschnitten | 35 / 63 ms | 16 / 21 ms |
Erste Anfrage des zweiten Mandanten trifft den Cache des ersten Mandanten | ja | nein |
Ein frisch gestarteter Prozess beantwortet seine erste Anfrage nach etwa 4,1 s Django-Setup plus der kalten Anfrage; das kalte p99 ist durch die Garbage Collection getrieben und bleibt über 0,1 s; die Thread-Zahlen schließen den Global Interpreter Lock von CPython ein.
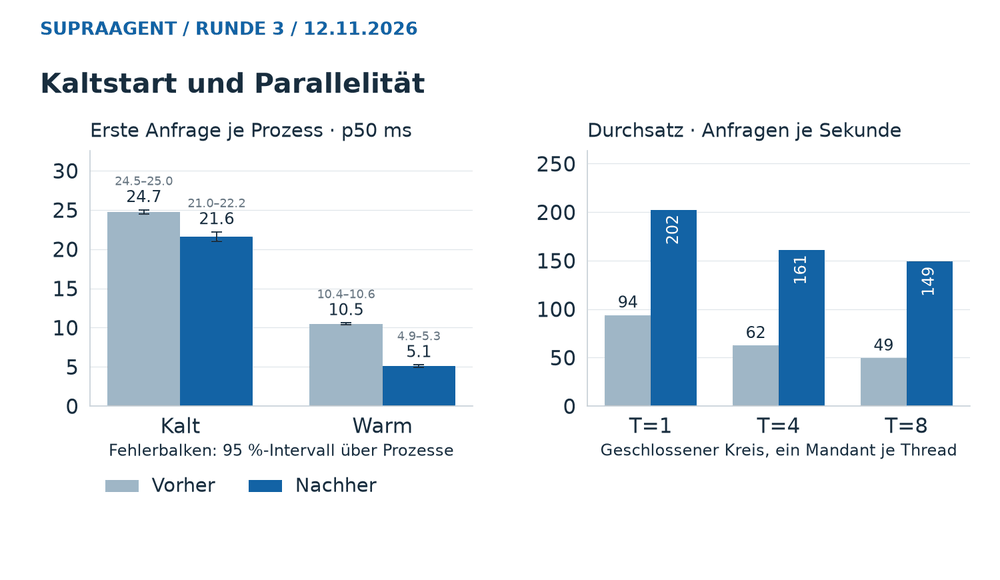
7. Kaltstart und Parallelität: mittlere Mediane je Prozess mit 95 %-Intervallen (die Tabelle berichtet gepoolte Perzentile, daher dort 24,8 und 21,5) und Durchsatz im geschlossenen Regelkreis, vorher und nachher.
Kontext-Fixtures: Quellen-Recall je Suchverfahren
Verfahren | Quellen-Recall (5 Fälle) | Faktenpräsenz (4 Fälle) |
|---|---|---|
BM25 | 65 % | 50 % |
Hash-Vektoren | 65 % | 50 % |
Graph, 1 Hop | 90 % | 75 % |
Graph, 3 Hops | 100 % | 100 % |
Hybrider Graph | 100 % | 100 % |
Diese Studie wurde in der aktuellen Runde nicht erneut ausgeführt; die Zahlen und die Abbildung stammen aus dem vorherigen Nachweispaket (9 Fixture-Fälle × 5 Suchverfahren × 3 Wiederholungen = 135 Ausführungen; Recall über die 5 annotierten Fälle, Faktenpräsenz über die 4 Fälle mit Referenzfakt). Drei Graph-Hops finden in diesen kleinen, selbst verfassten Fixtures jede erwartete Quelle und jeden Referenzfakt. Das ist eine Integrationsdiagnose: wörtliche Faktenpräsenz belegt keine Schlussfolgerung, und synthetische benchmark.invalid-Adressen sind Testkennungen.
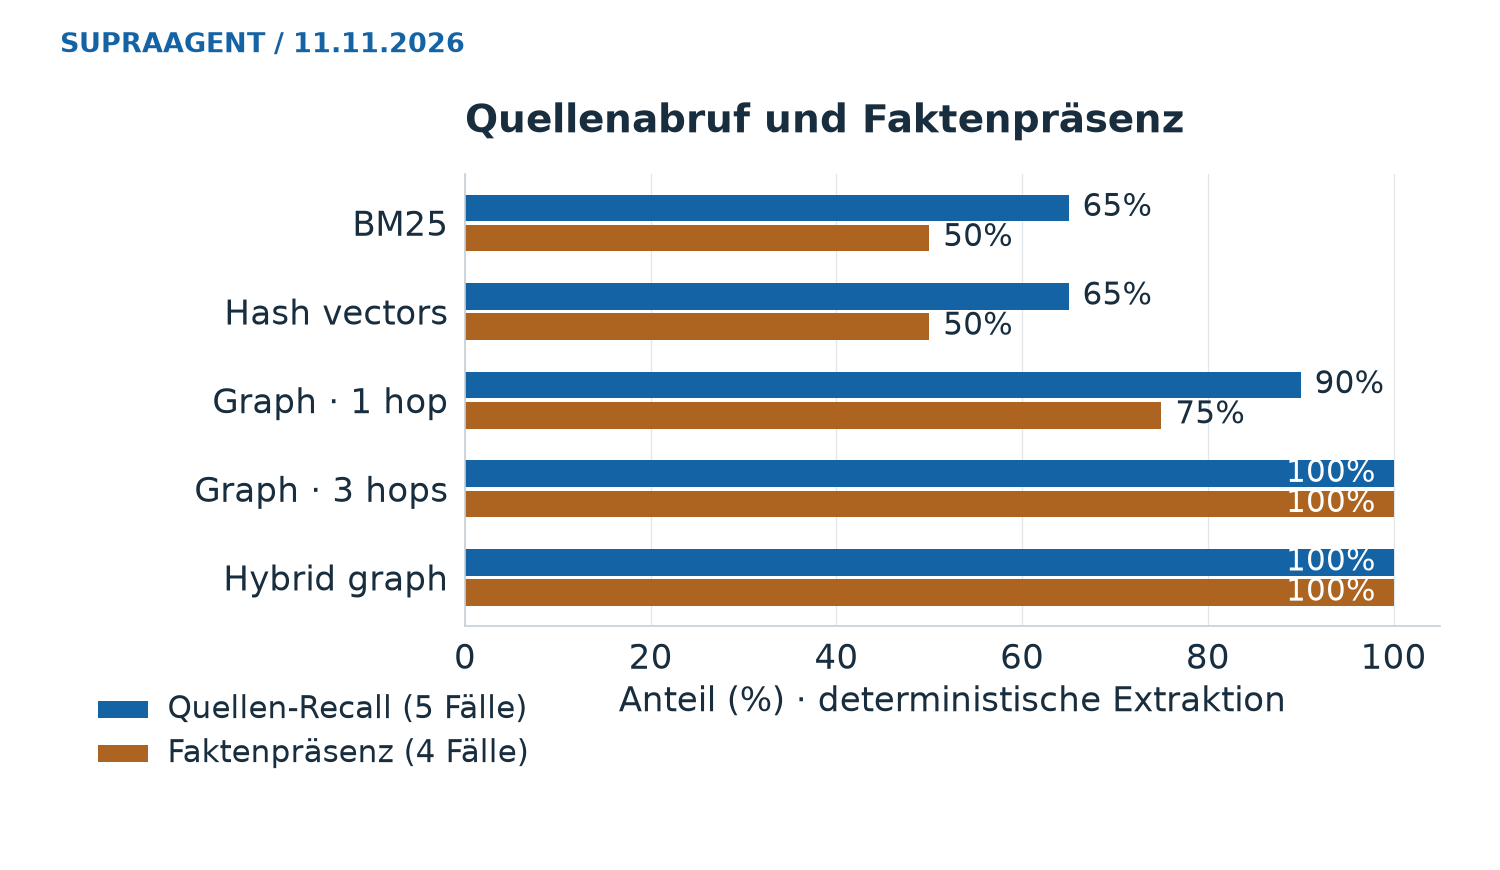
8. Kontext-Fixtures: Quellen-Recall über fünf annotierte Fälle und wörtliche Faktenpräsenz über vier Fälle. Misst keine semantische Korrektheit.
Was Quellenlinks belegen
Jede numerische Quellenmarkierung im Modul-Replay löst auf eine zugelassene Quellen-ID auf, mit null verlorenen oder unaufgelösten Markierungen über alle 576 Läufe. Die Auflösung von Quellen-IDs ist strukturell, keine semantische Quellenstützung. Antwortkorrektheit, Übersetzungsqualität, Supportnutzen und Prozesserfolg bleiben ohne unabhängige Bewertung ungemessen.
Begutachtete Methodik
Das Design folgt begutachteten Arbeiten; jede DOI im Forschungsverzeichnis des Nachweispakets wurde über Crossref verifiziert, und Einträge ohne DOI verlinken auf ihre Proceedings-Seiten. Die Arbeiten leiten die Messungen und zertifizieren SupraAgent nicht.
Robertson, Zaragoza und Taylor (CIKM 2004), Simple BM25 extension to multiple weighted fields: Feldgewichtung für den Abschnittstitel.
Robertson und Zaragoza (2009), The Probabilistic Relevance Framework: BM25 and Beyond: das Scoring-Modell und seine Statistiken je Dokument.
Craswell et al. (WSDM 2008), An experimental comparison of click position-bias models: warum die zuerst gelistete Quelle gesondert gemessen wird.
Lavrenko und Croft (SIGIR 2001), Relevance based language models: der Feedback-Schritt für Modulkohärenz, implementiert und abgeschaltet.
Tao und Zhai (SIGIR 2007), An exploration of proximity measures in information retrieval: die Proximity-Alternative, die geprüft und nicht übernommen wurde.
Sakai (SIGIR 2006), Evaluating evaluation metrics based on the bootstrap und Smucker, Allan und Carterette (CIKM 2007), A comparison of statistical significance tests for information retrieval evaluation: gepaarte Bootstrap-Intervalle und Vorzeichenwechsel-Tests über Fragefamilien.
Dwork et al. (Science 2015), The reusable holdout: warum der Holdout vor dem Tuning versiegelt und einmal ausgewertet wurde.
Card, Robertson und Mackinlay (CHI 1991), The information visualizer: die 0,1-Sekunden-Wahrnehmungsschwelle zum Lesen der lokalen Laufzeit.
Liu et al. (TACL 2024), Lost in the Middle: Position der Belege in langen Kontexten.
Bai et al. (ACL 2024), LongBench: warum Faktenerhalt über Zeichenlängen kein Modellverständnis ist.
Gao et al. (EMNLP 2023), ALCE: Antwortqualität und Zitatqualität sind getrennt.
Amershi et al. (CHI 2019), Guidelines for Human-AI Interaction: Grenzen in der Antwort sichtbar machen.
Zou, Geng, Wang und Jia (USENIX Security 2025), PoisonedRAG und Greshake et al. (AISec 2023), Not What You've Signed Up For: der Stresstest für Korpusvergiftung und indirekte Injektion.
Broder (SEQUENCES 1997), On the resemblance and containment of documents und Bernstein und Zobel (CIKM 2005), Redundant documents and search effectiveness: Zusammenfassung von Beinahe-Duplikaten über Dokumente hinweg.
Georges, Buytaert und Eeckhout (OOPSLA 2007), Statistically rigorous Java performance evaluation und Dean und Barroso (CACM 2013), The tail at scale: Kaltstarts über unabhängige Prozesse und Tail-Latenz unter Parallelität.
Lewis et al. (NeurIPS 2020), Retrieval-Augmented Generation: Suche und Generierung werden als getrennte Stufen berichtet.
Yao et al. (ICLR 2025), tau-bench: Prozessleistung braucht Ergebnisprüfungen gegen den resultierenden Zustand, die dieser Benchmark nicht ausführt.
Nachweise, Reproduktion und Grenzen
Berichte, archivierte Quellen, Rohantworten, die Läufe vom Rundenbeginn, Abbildungen, die Review-Befunde und Reproduktionsbefehle liegen im Nachweispaket (GitHub-Zugang erforderlich). Das Paket friert Quell-Hashes vor und nach jedem Lauf ein und ist mit SHA-256 gefingerprintet; ein explizites Gate von 537 Tests besteht auf dem gemessenen Code. Änderungen wurden nur ausgeliefert, wenn sie vor der Messung festgelegte Gates bestanden: keine Routing-Regression, kein verlorenes Zitat, keine schlechtere Angriffszelle, keine Langquellenzelle unter dem vorherigen Code. Eine Langquellenprüfung, die erste Zeile bei Ködern, schlägt vorher und nachher identisch fehl und wird als Grenze geführt. Zwei Funktionen, die ein Gate nicht bestanden, sind implementiert, aber abgeschaltet und werden in beiden Zuständen berichtet (Kohärenz: Hit@1 77 gegenüber 91 von 96 mit 9 verlorenen Zitaten; Quellenverweis: Angreiferdokument zitiert in 88 gegenüber 96 von 96 unter Hub-Stuffing).
Eine Qualitätsaussage auf Produktebene bräuchte zusätzlich unabhängig bewertete Antworten und Quellenstützung, frische Fragen aus Kundendomänen, eine menschliche Bewertung der Nutzererfahrung, Produktionslatenz unter Last, verteidigtes Ranking unter Autoritäts- und Hub-Dokumenten und isolierte Prozessläufe mit geprüftem Vorher-Nachher-Zustand. Bis dahin stützt dieser Benchmark konkrete Such-, Erhalt-, Robustheits- und Regressionsdiagnosen. Er belegt keine allgemeine Genauigkeit, keine erfolgreichen Live-Prozesse und keine Überlegenheit gegenüber anderen Agenten.